La guía del video con IA
La imagen ya la dominan. Ahora la ponemos a respirar. Aquí está todo lo que necesitan para generar video con IA: las cuatro formas de arrancar una toma, la estructura del prompt, cómo mover la cámara, cómo darle voz a un personaje, cómo lograr que no cambie de cara entre tomas, y qué modelo conviene en cada caso — con ejemplos reales que pueden ver y prompts listos para copiar.
01Los cuatro modos de entrada
Todas las plataformas ofrecen lo mismo, aunque cada una lo llame distinto. La pregunta que hay que hacerse siempre es: ¿qué papel juega mi imagen en esta toma?
Texto a video
Solo escribes. El modelo inventa el personaje, el lugar y la luz desde cero.
Úsalo para: explorar ideas rápido, paisajes, objetos y tomas donde no importa quién aparece.Imagen a video (frame inicial)
Tu imagen es el primer fotograma exacto. El video arranca justo ahí y el movimiento sale de esa foto.
Úsalo para: el 80% de tu trabajo. Es la forma de tener control real: primero armas la imagen perfecta, luego la mueves.Primer y último fotograma
Le das dos imágenes: dónde empieza y dónde termina. El modelo inventa el camino entre las dos.
Úsalo para: transiciones, transformaciones y para encadenar dos tomas que ya tienes.Referencias (modo Omni)
Subes varias imágenes como guía, no como punto de partida: un personaje, un producto, un fondo, un estilo. El modelo los combina en una escena nueva.
Úsalo para: juntar en una misma toma cosas que están en fotos distintas, o mantener a tu personaje escena tras escena.02La estructura del prompt: 5 bloques
Un prompt de video sólido se arma por partes. No hace falta usar las cinco siempre, pero cada una que agregas es una decisión que le quitas al azar:
Tipo de toma
El género y el estilo. Define todo el look de un plumazo.
toma cinematográfica · video casual de celular · animación · stop motion · anuncio de productoSujeto y acción
Quién aparece, qué hace y qué dice. El diálogo siempre entre comillas.
un hombre con abrigo negro enciende un cigarro y dice: "…"Entorno y detalles
El lugar, la hora, el clima y la atmósfera del set.
campo de tierra, cielo gris nublado, luz de tardeMovimiento de cámara
Cómo se mueve la cámara durante la toma. Sin esto, el modelo decide por ti.
push-in lento · la cámara lo sigue de cerca · órbita alrededorSonido y efectos
Lo que se oye y lo que flota en el aire: ambiente, efectos, partículas.
neblina fría, viento, ruido lejano de un trenToma cinematográfica de un hombre con abrigo negro de los años 30 que enciende un cigarro y dice, en español latino con tono serio: "No vine a pedir permiso… vine a cobrar", de pie en un campo de tierra bajo un cielo gris nublado, con push-in lento de cámara y neblina fría flotando y ruido lejano de ciudad.
03Mover la cámara
Este es el bloque que más diferencia hace y el que casi nadie escribe. Con estos ocho movimientos resuelves prácticamente cualquier toma:
La cámara hace un push-in lento y continuo hacia el rostro del sujeto, con un ligero temblor de cámara en mano. Velocidad constante y suave, el horizonte se mantiene nivelado, y termina en un primer plano limpio y estable.
04Voz y diálogo
El modelo genera la voz solo — pero tú tienes que decirle cómo hay que decir la frase. Ese detalle es lo que separa un diálogo plano de uno que se siente actuado. Especifica siempre estas cuatro cosas:
- Idioma y acento. "Español latino" no suena igual que "español de España" o "español de Colombia". Si no lo dices, el modelo elige por ti y casi siempre elige mal.
- Tono. Serio, cálido, amenazante, cansado, divertido. Es la intención de la línea.
- Ritmo. Rápido y nervioso, o lento y pausado. Marca el pulso de la escena.
- Pausas y respiraciones. Los modelos actuales entienden un suspiro, un titubeo o un silencio en medio de la frase, y eso es lo que la vuelve creíble.
El sujeto mira a cámara y dice, en español latino, con tono serio y ritmo pausado, tras una breve pausa: "No vine a pedir permiso… vine a cobrar."
05Que tu personaje no cambie
El problema clásico: generas cinco tomas y en cada una tu protagonista tiene otra cara. Hay dos formas de resolverlo, y se complementan.
Opción A · La hoja de personaje
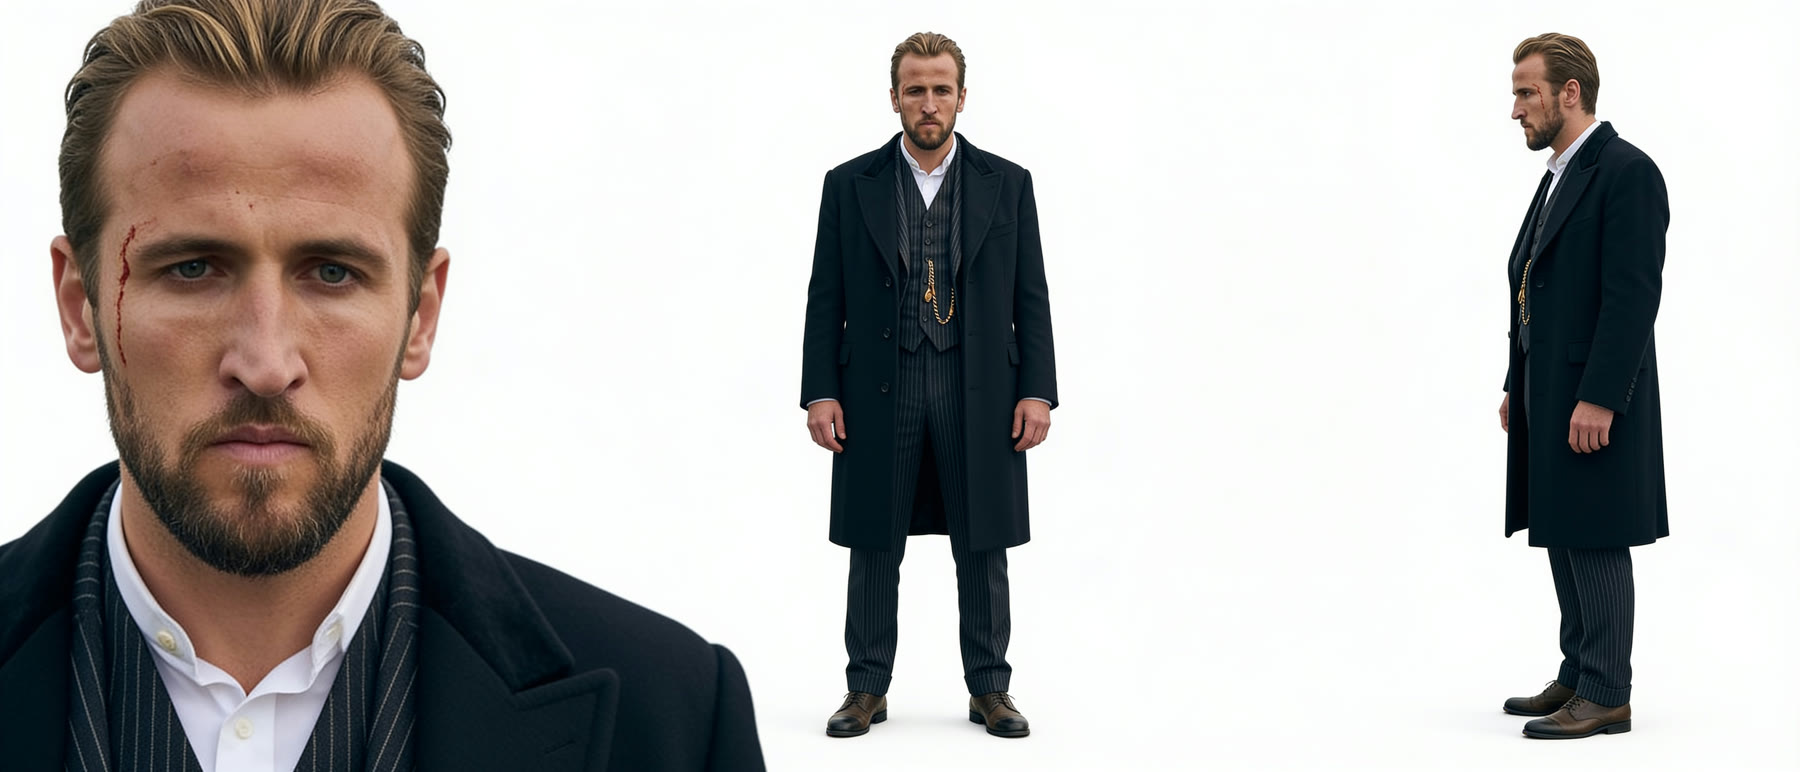
Es una sola imagen con tu personaje visto de tres maneras distintas sobre fondo blanco. Esa imagen se convierte en la referencia que le das al modelo de video en cada toma nueva — es, de lejos, lo que mejor funciona.
Tenemos dos versiones del prompt, y cambian en qué le muestras al modelo. Elige según lo que más te importe cuidar:
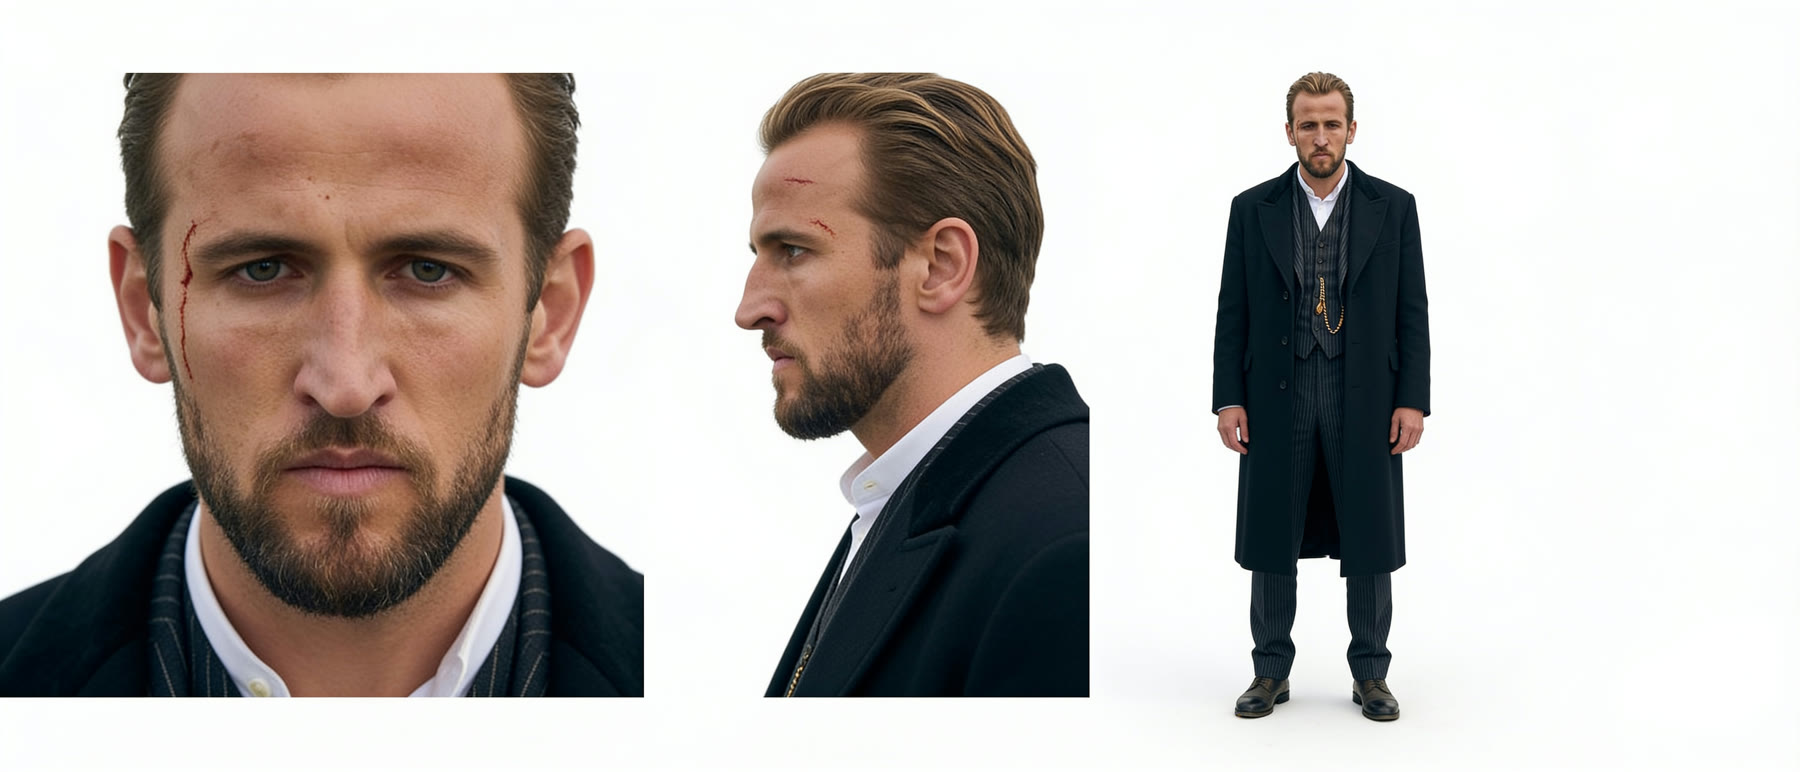
La versión 1 le da dos vistas del cuerpo completo: úsala cuando tu personaje aparezca de lejos o caminando, y lo que tengas que cuidar sea la ropa y la silueta. La versión 2 le da dos close-ups del rostro: úsala cuando vayas a hacer primeros planos, diálogo o cualquier toma donde la cara sea lo importante. Si dudas, genera las dos — cuestan lo mismo y luego pruebas cuál te respeta mejor al personaje.
Versión 1 · Rostro, cuerpo entero y perfil
Hoja de personaje de UN SOLO personaje, organizada en una única fila horizontal sobre un fondo blanco puro (#FFFFFF).
La fila contiene exactamente 3 tomas del MISMO personaje, en este orden exacto de izquierda a derecha:
1. CLOSE-UP DEL ROSTRO — retrato cerrado de frente, cámara perfectamente centrada a la altura de los ojos, mirada directa hacia el lente, expresión neutral, cabeza y hombros visibles, proporciones faciales precisas y detalles claros del rostro, piel y cabello.
2. CUERPO COMPLETO DE FRENTE — figura completa visible de pies a cabeza, de pie en una postura natural, brazos relajados a los costados, pies ligeramente separados, cuerpo completamente orientado hacia la cámara, cámara perfectamente centrada y a la altura de los ojos.
3. PERFIL LATERAL — vista lateral pura de 90 grados, cuerpo completo visible de pies a cabeza, cámara perfectamente alineada con el costado del rostro y del cuerpo, solo un ojo visible, brazos relajados, postura natural, con el cabello, la oreja, la nariz, la mandíbula, la silueta del vestuario y el calzado claramente visibles.
Las 3 tomas deben mostrar exactamente el mismo diseño de personaje, sin variaciones entre imágenes. Mantener idénticos los rasgos faciales, peinado, tono de piel, edad, proporciones corporales, vestuario, accesorios, materiales y colores de la imagen de referencia.
Usar iluminación de estudio neutral, suave, frontal y difusa en las 3 tomas, con sombras mínimas y sin contraste dramático. El fondo debe ser completamente plano, uniforme y blanco puro.
Las tomas deben estar distribuidas de manera uniforme en una composición horizontal limpia. Sin texto, sin etiquetas, sin bordes, sin marcos, sin objetos adicionales y sin otros personajes.
Usar [PERSONAJE DE REFERENCIA] como sujeto. Preservar con máxima precisión su identidad y apariencia visual en las 3 tomas.
Versión 2 · Dos close-ups del rostro y el cuerpo entero
Cambia la segunda toma: en lugar del perfil de cuerpo entero, pide un primer plano del rostro de perfil. Le da al modelo el doble de detalle de la cara.
Hoja de personaje de UN SOLO personaje, organizada en una única fila horizontal sobre un fondo blanco puro (#FFFFFF).
La fila contiene exactamente 3 tomas del MISMO personaje, en este orden exacto de izquierda a derecha:
1. CLOSE-UP DEL ROSTRO DE FRENTE — retrato cerrado de frente, cámara perfectamente centrada a la altura de los ojos, mirada directa hacia el lente, expresión neutral, cabeza y hombros visibles, proporciones faciales precisas y detalles claros del rostro, piel y cabello.
2. CLOSE-UP DEL ROSTRO DE PERFIL — retrato cerrado en vista lateral pura de 90 grados, cámara perfectamente alineada con el costado del rostro a la altura de los ojos, solo un ojo visible, expresión neutral, cabeza y hombros visibles, con el cabello, la oreja, la nariz, la mandíbula y el contorno del perfil claramente visibles y detallados.
3. CUERPO COMPLETO DE FRENTE — figura completa visible de pies a cabeza, de pie en una postura natural, brazos relajados a los costados, pies ligeramente separados, cuerpo completamente orientado hacia la cámara, cámara perfectamente centrada y a la altura de los ojos, con el vestuario y el calzado claramente visibles.
Las 3 tomas deben mostrar exactamente el mismo diseño de personaje, sin variaciones entre imágenes. Mantener idénticos los rasgos faciales, peinado, tono de piel, edad, proporciones corporales, vestuario, accesorios, materiales y colores de la imagen de referencia.
Usar iluminación de estudio neutral, suave, frontal y difusa en las 3 tomas, con sombras mínimas y sin contraste dramático. El fondo debe ser completamente plano, uniforme y blanco puro.
Las tomas deben estar distribuidas de manera uniforme en una composición horizontal limpia. Sin texto, sin etiquetas, sin bordes, sin marcos, sin objetos adicionales y sin otros personajes.
Usar [PERSONAJE DE REFERENCIA] como sujeto. Preservar con máxima precisión su identidad y apariencia visual en las 3 tomas.
En las dos versiones, cambia [PERSONAJE DE REFERENCIA] por la descripción de tu personaje, o simplemente súbele su foto como referencia.
Opción B · Referencia de personaje del propio modelo
Las plataformas ya traen un espacio para "personaje" o "elemento" donde subes su foto y el modelo se compromete a respetarlo. Sirve igual para productos: subes tu botella o tu tenis y aparece idéntico en todas las tomas. Es lo que hace posible un anuncio completo con IA.
06Varias tomas en una sola generación
Los modelos nuevos pueden entregarte una secuencia ya editada: dentro de un mismo clip hay tres o cuatro cortes distintos. Se llama multishot (o multi-shot). Cuesta un poco más por generación, pero te sale mucho más barato que generar cuatro videos por separado — y la continuidad entre planos es perfecta porque los pensó todos juntos.
Y esta es la fórmula que dirige al modelo para que realmente haga los cortes que tú quieres:
Genera una secuencia multishot cinemática de [DESCRIBE LA ESCENA EN UNA LÍNEA].
Muestra cortes rápidos con diferentes planos: [PLANO 1], [PLANO 2], [PLANO 3] — no incluyas más de 4.
Movimiento: cinematográfico y controlado, con ligero movimiento de cámara en mano; la cámara está en constante movimiento en todos los planos.
Color: corrección de color cinematográfica, contraste marcado y tonos de piel naturales.
Sonido: ambiente realista del entorno, respiraciones y los sonidos propios de la acción.
07Los conceptos, en movimiento
Para que vean la diferencia con sus propios ojos, generamos tres videos con el mismo personaje de la guía de imagen cinematográfica, cambiando solo el concepto que queríamos mostrar. Sin retoque, tal como salieron.
08¿Qué modelo uso y cuándo?
No existe el "mejor modelo": existe el correcto para cada toma. Esta es la guía práctica del curso a día de hoy.
Seedance 2.0
El más potente ahora mismo- El mejor para acción, efectos y movimiento complejo.
- Genera el audio en la misma pasada y respeta muy bien las referencias.
- Es el más caro, y se pone quisquilloso con caras de personas famosas.
Kling 3.0
Rostros, voz y multishot- El mejor en expresiones faciales y sincronía de labios.
- Su multishot es el más fácil de dirigir; el audio en español salió muy bien.
- Más barato que Seedance; algo más flojo en escenas de acción.
Veo 3.1
Transiciones y contenido rápido- Muy bueno con primer y último fotograma y con "ingredientes" (varias referencias).
- Permite extender tomas sin perder el audio y trabaja en vertical.
- Ideal para contenido tipo UGC y secuencias encadenadas.
Google Omni
Texto en pantalla y motion graphics- Entiende instrucciones habladas y escribe texto legible dentro del video.
- Acepta texto, imagen y video como entrada; de 3 a 10 segundos.
- Se queda corto en duración y calidad frente a los dos primeros.
Grok Video
El menos restrictivo- Sirve para escenas que otras plataformas bloquean.
- Calidad por debajo de los anteriores; úsalo como comodín.
Herramientas de edición
Para arreglar video que ya existe- Runway Aleph y Google Omni: quitan o agregan elementos y cambian la luz de un video con palabras.
- Kling Motion Control: pasa el movimiento de un video a tu imagen fija.
09Mismo prompt, cuatro modelos
Este es el ejercicio comparativo que hicimos: un solo prompt, generado tal cual en los cuatro modelos principales. Fíjense en tres cosas: el movimiento de la cámara, si el texto de la claqueta sobrevive, y qué tan natural se ve la persona.
Toma cinematográfica en un set de filmación nocturno iluminado con neón verde: la cámara avanza lentamente hacia una directora de cine que baja una claqueta con el texto 'CONTENIDO CON IA' y sonríe a cámara; ambiente de rodaje profesional, look de película
10Trucos de producción
Lo que separa un video bonito de uno que sí puedes publicar no está en el prompt: está en cómo trabajas después de generar.
- ▸No todos los segundos sirven, y está bien. De un clip de 8 segundos quizá te quedes con 2. Esos 2 segundos, bien colocados en el montaje, valen más que 8 mediocres. Nadie publica una generación tal cual.
- ▸Para extender una toma, corta donde termina la acción, no donde termina el clip. Si el personaje deja de hablar al segundo 4 pero el video dura 6, saca tu captura en el segundo 4: si usas el último fotograma real, el personaje se queda tieso como robot al continuar.
- ▸Genera varias opciones del mismo prompt. Todas las plataformas permiten pedir 2 o 4 resultados a la vez. Es la forma más rápida de encontrar la buena; casi nunca sale a la primera.
- ▸Prueba en calidad baja, produce en alta. Afina el prompt con generaciones baratas y solo cuando ya funcione, súbelo a máxima calidad. Ahorra la mitad de tus créditos.
- ▸Sube la resolución al final. Casi todas las plataformas tienen un botón para escalar el video terminado. Revísalo: a veces gana nitidez y a veces pierde textura.
- ▸Apaga el audio cuando no lo necesites. Encarece cerca del doble. Si la toma va con música encima, genérala muda.
- ▸Guarda los prompts que funcionaron. Un prompt bueno es un activo: reutilízalo cambiando solo el sujeto o el lugar. Ahí es donde de verdad se acelera el trabajo.
11Los cinco errores de principiante
- ✕Pedir tres acciones en cinco segundos. Una toma, una acción. Si necesitas más, son más tomas.
- ✕Olvidar la cámara. Sin movimiento indicado, el modelo elige el más aburrido o inventa uno que no querías.
- ✕Escribir el diálogo sin comillas. El modelo termina narrando tu instrucción en vez de decir la frase.
- ✕Volver a describir al personaje cuando ya subiste su foto. Es la causa número uno de que "se le cambie la cara".
- ✕Esperar que la primera generación sea la buena. Iterar no es fracasar: es el trabajo.
12Llévate las herramientas
Todo lo de esta guía, convertido en herramientas que puedes usar mañana mismo:
Director de Video IA
Le cuentas la toma que imaginas y te devuelve el prompt de video armado con los 5 bloques, el modo de entrada correcto y el modelo recomendado. Incluye modo multishot.
Ir a las skillsSeedance Video Mastery
La skill avanzada para exprimir Seedance 2.0: referencias, consistencia de personaje, formato por tomas y reglas de escritura seguras.
⬇ Descargar la skillMovimientos de cámara
46 movimientos con vista previa en 3D y su prompt listo para copiar. El vocabulario del bloque 04 de esta guía.
Abrir la bibliotecaTu tarea de la semana
Elige una de las imágenes que generaste en la Clase 2 y conviértela en una toma de 5 segundos usando los 5 bloques. Luego genera esa misma escena solo con texto, sin la imagen, y compáralas. Traigan las dos versiones a la próxima clase.